Webdesign · Entwicklung · SEO
Kontextfenster (KI)
Wie viel Information eine KI gleichzeitig nutzen kann
Redaktionell geprüft ·
Verständlich erklärt
Das Kontextfenster ist die begrenzte Menge an Information, die ein KI-Sprachmodell während einer Anfrage verarbeiten kann. Seine Größe wird in Tokens angegeben. Dazu gehören die verwendeten Eingaben und der Platz für die Generierung. Welche Grenzen genau gelten, hängt vom Modell und der Anwendung ab.
Stell dir einen Schreibtisch vor. Darauf liegen deine Frage, Unterlagen und Notizen aus dem bisherigen Gespräch. Für die Antwort brauchst du ebenfalls Platz. Ein größerer Tisch erlaubt mehr Material. Er sorgt aber nicht automatisch dafür, dass jede Notiz richtig eingeordnet wird. Dieses Bild hilft, lange KI-Gespräche bewusster zu gestalten.
Was auf die gemeinsame Arbeitsfläche kommt
Deine letzte Nachricht ist nur ein Teil der Eingabe. Die Anwendung kann zusätzlich Arbeitsanweisungen, frühere Nachrichten, Dateiinhalte und Ergebnisse von Werkzeugen mitgeben. Auch technische Nachrichtenstrukturen benötigen Platz. Welche Informationen tatsächlich beim Modell ankommen, entscheidet die konkrete Anwendung.
Ein im Chat sichtbarer Anhang muss deshalb nicht vollständig in jeder Anfrage stecken. Eine Anwendung kann daraus Text extrahieren oder nur passende Ausschnitte abrufen. Bei Bildern und Audio gelten modellabhängige Zählregeln. Wenn du ein Budget planst, orientiere dich an der vollständigen Anfrage und den Nutzungsdaten des Anbieters, nicht allein an der Länge deiner letzten Frage.
Auf einen Blick
Ein einfaches Rechenbeispiel
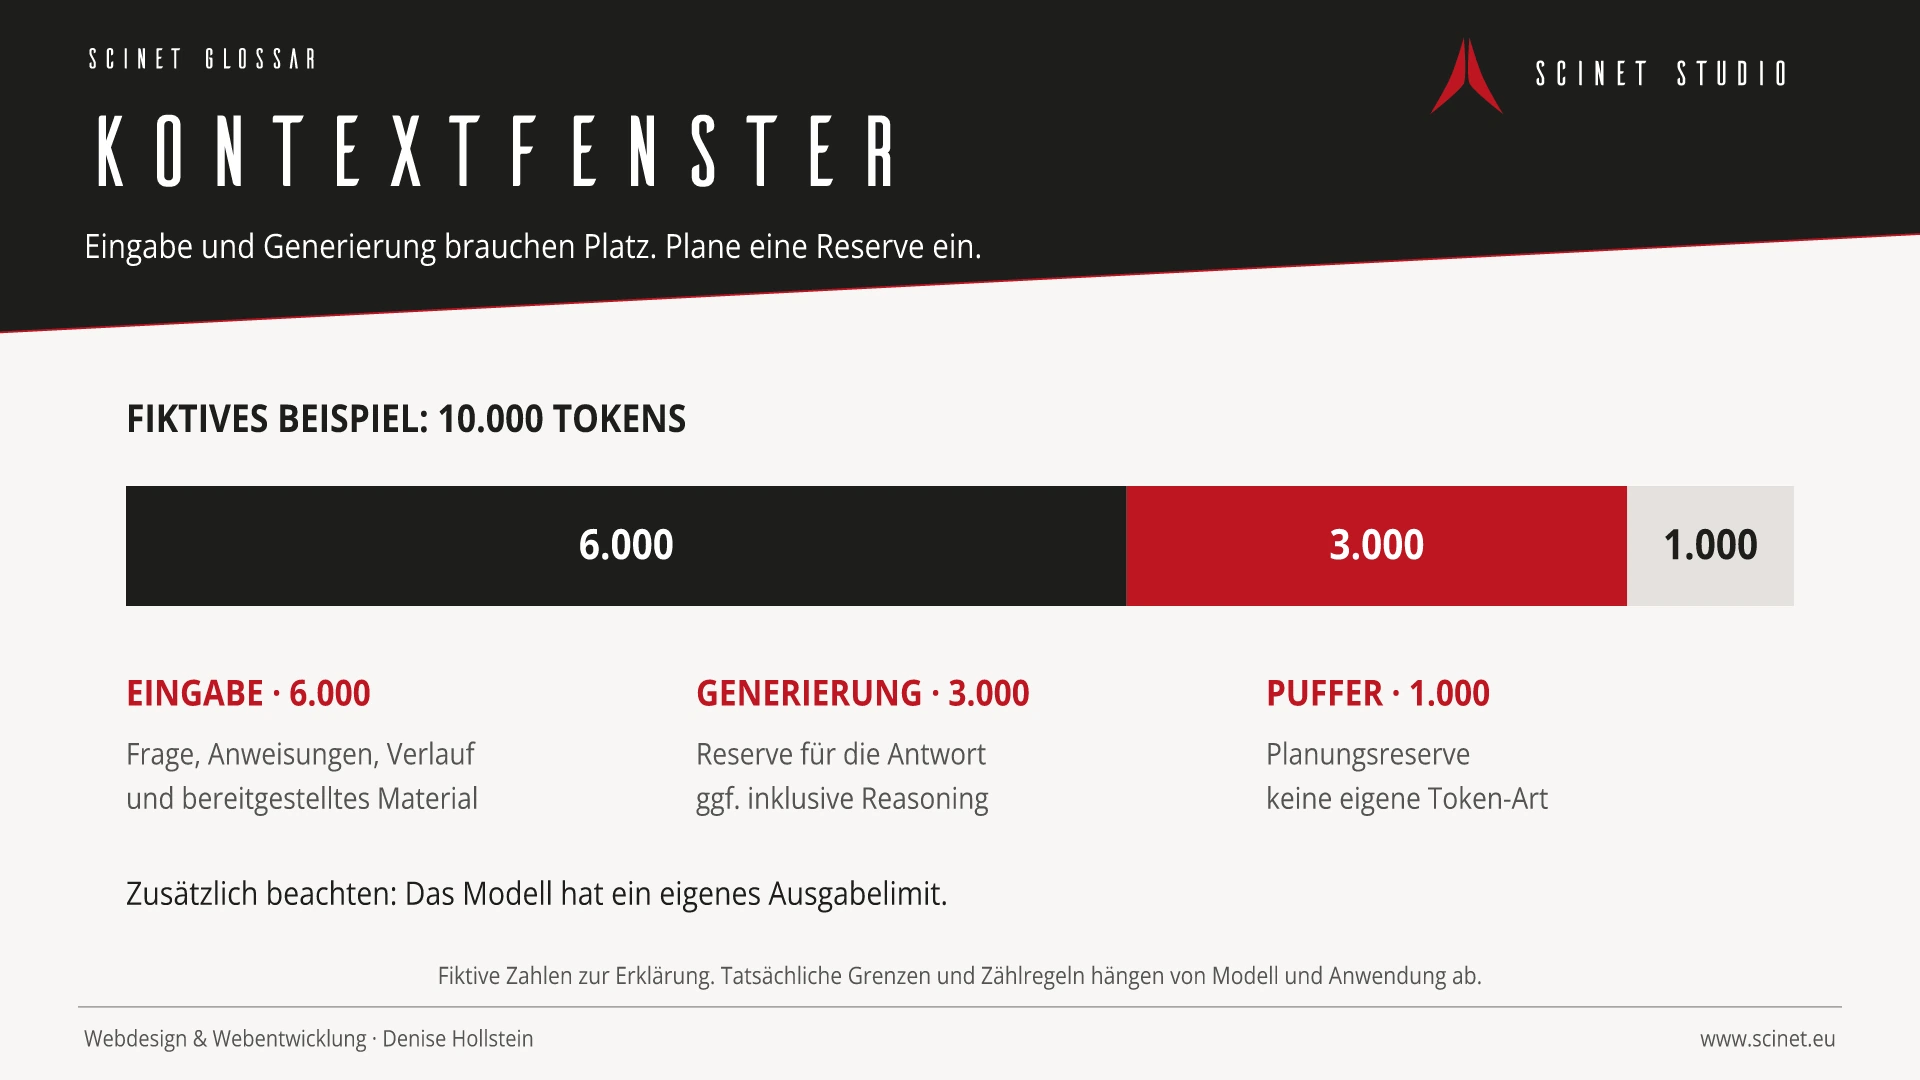
Nehmen wir ein erfundenes Kontextfenster mit 10.000 Tokens. Deine vollständige Eingabe belegt 6.000. Du planst 3.000 für die Generierung ein und lässt 1.000 als Puffer. Zusammen sind das 10.000. Die Grafik zeigt genau diese Aufteilung. Der Puffer ist deine Planungsreserve, keine besondere Token-Art.
Prüfe zusätzlich das separate Ausgabelimit des Modells. Freier Kontext erlaubt nicht automatisch eine beliebig lange Antwort. Bei Reasoning-Modellen kann das Generierungsbudget außerdem interne Reasoning-Tokens enthalten; bei OpenAI teilen sie sich das Ausgabelimit mit der sichtbaren Antwort. Die Zahlen hier illustrieren die Planung und beschreiben kein bestimmtes Produkt.
Was passiert, wenn das Fenster voll wird?
Es gibt keine einheitliche Reaktion für alle KI-Produkte. Eine Anfrage kann an einer Grenze scheitern. Eine Anwendung kann ältere Inhalte weglassen oder den bisherigen Stand verdichten. Eine unterbrochene Antwort kann wiederum am Ausgabelimit liegen. Schau deshalb auf die konkrete Meldung, statt jedes Problem als „vergessen“ einzuordnen.
Bei der sogenannten Compaction wird bisheriger Kontext in eine kleinere Darstellung überführt, damit das Gespräch weitergehen kann. Das muss keine lesbare Zusammenfassung sein: OpenAI dokumentiert dafür auch eine für Menschen nicht lesbare Repräsentation. Für deine Arbeit ist entscheidend, ob Ziele, Entscheidungen und offene Punkte anschließend noch verfügbar sind. Kontrolliere wichtige Details lieber am Originaldokument.
Kontext, Gedächtnis und Training unterscheiden
Der Chatverlauf ist das Gespräch, das eine Anwendung aufbewahrt oder anzeigt. Der aktive Kontext ist das Material, das für die aktuelle Verarbeitung bereitsteht. Eine Gedächtnisfunktion kann ausgewählte Informationen über Gespräche hinweg speichern und später wieder einbringen. Diese drei Dinge sind nicht identisch.
Auch das im Training erworbene Wissen eines LLM ist etwas anderes. Ein Dokument in den Kontext zu legen verändert nicht automatisch die trainierten Modellparameter. Ob ein Anbieter Inhalte für spätere Trainingszwecke verwendet, ist wiederum eine Frage seiner Datenregeln und deiner Einstellungen. Die Kontextgröße beantwortet diese Frage nicht.
Warum größer nicht automatisch zuverlässiger ist
Eine große Kapazität sagt zunächst, wie viel hineinpassen kann. Wie gut ein Modell die entscheidenden Informationen nutzt, musst du anhand deiner Aufgabe beurteilen. Die Studie „Lost in the Middle“ zeigte 2023 bei den untersuchten Modellen und Aufgaben, dass die Position relevanter Informationen die Ergebnisse beeinflusste. Das ist kein pauschaler Messwert für heutige Modelle, aber ein guter Anlass, die tatsächliche Leistung zu prüfen.
Für einen Dokumentvergleich kannst du beispielsweise vorab drei bekannte Unterschiede festhalten und anschließend kontrollieren, ob die KI sie korrekt findet. Bitte um konkrete Fundstellen. So prüfst du die Qualität an deinem Material, statt sie aus einer beeindruckenden Tokenzahl abzuleiten.
So hältst du längere Aufgaben übersichtlich
Lege zu Beginn fest, welches Ergebnis du brauchst und welche Bedingungen gelten. Trenne aktuelle Vorgaben von verworfenen Ideen. Bei einem Neustart hilft eine kurze Übergabe mit Ziel, bestätigten Entscheidungen, wichtigen Quellen und offenen Fragen. Lies diese Übergabe selbst durch, bevor du dich darauf verlässt.
Für umfangreiche Wissensbestände kann ein RAG-System passende Textstellen suchen und in den Kontext einbringen. Es vergrößert das Fenster nicht; es wählt Material aus. Prüfe auch diese Auswahl: Fehlt eine entscheidende Quelle, kann die Antwort trotz guter Formulierung unvollständig bleiben. Manchmal ist es sinnvoller, eine Aufgabe in überprüfbare Schritte zu teilen, als alles in eine einzige Anfrage zu packen.
Codebeispiel aus der Praxis
Ein fiktives Budget nachrechnen
Eigenes Rechenbeispiel ohne API-Aufruf. Alle Werte sind erfunden und bereits in Tokens angegeben. Der Code zählt keine Texte und prüft kein reales Modell. Dessen Ausgabelimit und Zählregeln müssen zusätzlich berücksichtigt werden.
context_limit = 10000
input_tokens = 6000
output_budget = 3000
safety_buffer = 1000

required = input_tokens + output_budget + safety_buffer
print(required <= context_limit)  # True
print(context_limit - input_tokens)  # 4000
Quellen und weiterführende Informationen
- Dokumentation Conversation state: Managing the context window OpenAI · Geprüft
- Dokumentation Counting tokens OpenAI · Geprüft
- Dokumentation Reasoning models OpenAI · Geprüft
- Dokumentation Compaction OpenAI · Geprüft
- Dokumentation Retrieval OpenAI · Geprüft
- Forschung Lost in the Middle: How Language Models Use Long Contexts Nelson F. Liu et al. · arXiv / TACL · Geprüft
- Dokumentation Prompt caching OpenAI · Geprüft
