Webdesign · Entwicklung · SEO
Token (KI)
Bausteine, Kontext und Verbrauch verständlich erklärt
Redaktionell geprüft ·
Verständlich erklärt
Ein Token ist eine kleine Einheit, mit der ein KI-Sprachmodell Text verarbeitet. Das kann ein ganzes Wort sein, ein Wortteil oder ein Satzzeichen. Auch Leerzeichen spielen eine Rolle. Ein Tokenizer zerlegt den Text nach festgelegten Regeln und ordnet den Einheiten Zahlen zu: die Token-IDs.
Stell dir vor, du gibst einer KI einen langen Text und bittest um eine Zusammenfassung. Du siehst Absätze und Sätze. Das Modell erhält eine Folge von Tokens. Wenn du verstehst, wie diese Einheiten gezählt werden, werden Angaben zu Textlänge, Kontext und Verbrauch deutlich greifbarer. Du musst dafür keine Entwicklerin und kein Entwickler sein.
Vom Text zu vier Tokens
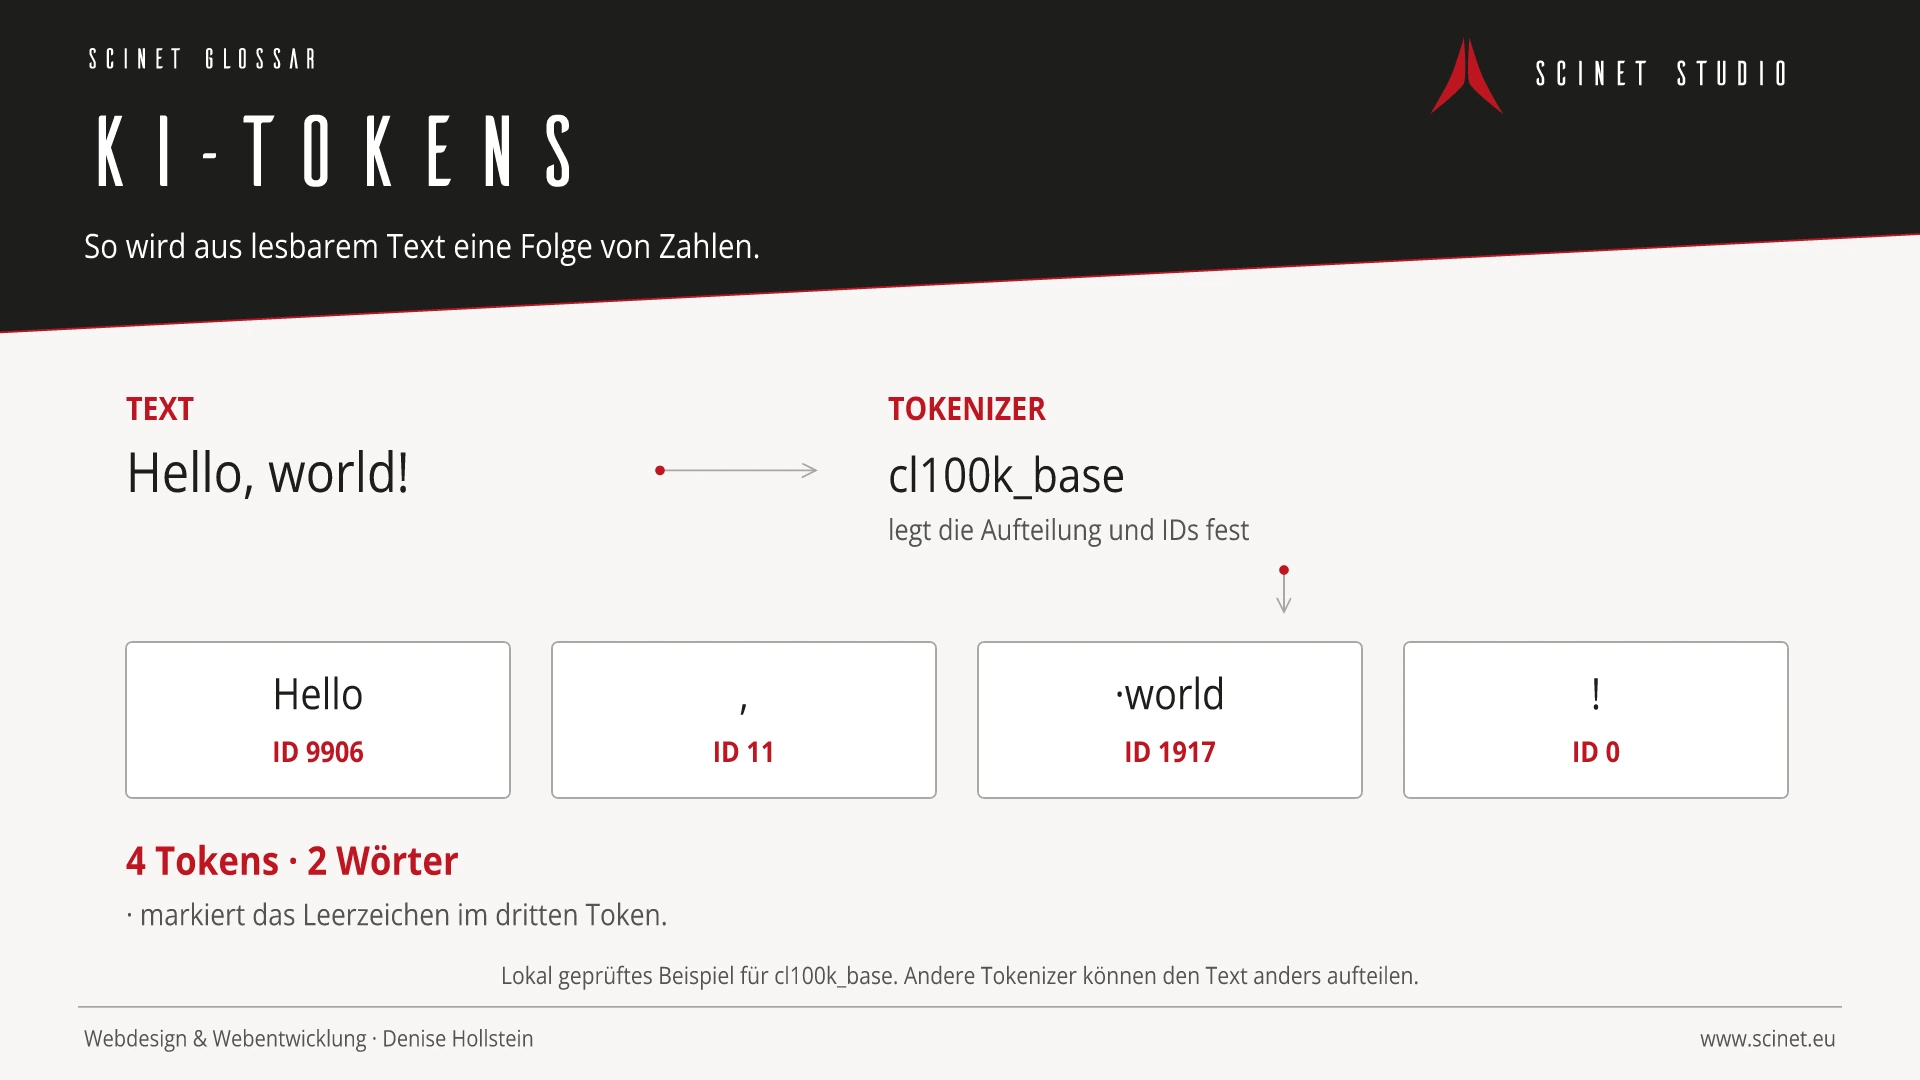
Nehmen wir Hello, world!. Mit dem Tokenizer cl100k_base entstehen vier Teile: Hello, ,, world und !. Die IDs lauten 9906, 11, 1917 und 0. Das Leerzeichen vor world gehört zum dritten Teil. Du siehst: Zwei Wörter ergeben hier vier Tokens.
Diese Aufteilung wurde für das Beispiel lokal geprüft. Sie gilt für genau diesen Text und diesen Tokenizer, nicht pauschal für jede KI. Andere Schreibweisen, Sprachen und Tokenizer können andere Ergebnisse liefern. Besonders lange Wörter, Code und Sonderzeichen lassen sich deshalb nicht zuverlässig über eine feste Wortzahl umrechnen. Das Codebeispiel unten macht die Zählung nachvollziehbar.
Auf einen Blick
Was das Kontextfenster damit zu tun hat
Das Kontextfenster beschreibt, wie viele Tokens ein Modell bei einer Anfrage berücksichtigen kann. Denke an eine begrenzte Arbeitsfläche: Deine Frage liegt dort gemeinsam mit Anweisungen, mitgegebenen Dokumenten und dem verwendeten Gesprächsverlauf. Auch für die erzeugte Antwort muss Platz bleiben. Bei manchen Modellen kommt interner Reasoning-Verbrauch hinzu.
Die maximale Ausgabelänge ist eine zusätzliche Grenze. Ein großes Kontextfenster bedeutet also nicht, dass die Antwort genauso lang werden darf. Und es ist kein dauerhaftes Gedächtnis. Was eine Anwendung aus früheren Gesprächen speichert, erneut mitgibt oder zusammenfasst, ist eine eigene Funktion. Wenn ein Chat Details verliert, hilft es oft, die entscheidenden Vorgaben noch einmal klar zusammenzustellen.
Eingabe, Ausgabe und Kosten auseinanderhalten
Eingabe-Tokens gehören zum Material, das das Modell erhält. Ausgabe-Tokens entstehen bei der Generierung. Bei einer API können dafür unterschiedliche Preise gelten. Die Zahl deiner sichtbaren Wörter allein sagt deshalb wenig über die Rechnung aus.
Manche Anbieter unterscheiden außerdem zwischengespeicherte Eingaben und Reasoning-Tokens. Prompt-Caching kann bereits berechnete Zustände eines unveränderten Prompt-Anfangs wiederverwenden; ein passender Cache-Treffer kann Eingabekosten reduzieren. Bei OpenAI zählen interne Reasoning-Tokens zur abgerechneten Ausgabe, obwohl du sie nicht als vollständigen Text siehst. Vergleiche deshalb die ausgewiesenen Nutzungskategorien mit der aktuellen Preisliste des konkreten Modells.
Ein Chat-Abonnement ist wiederum ein anderes Produkt als eine API-Abrechnung. Aus einer Tokenzahl lässt sich nicht automatisch ableiten, wie viele Nachrichten dein Tarif erlaubt.
So prüfst du den tatsächlichen Verbrauch
Für einen einzelnen Text hilft ein passender Tokenizer. Für eine vollständige Anfrage reicht diese Textzählung oft nicht aus: Nachrichtenrollen, Werkzeugbeschreibungen und andere Strukturen können zusätzliche Tokens benötigen. Bilder und Audio werden ebenfalls nach eigenen, modellabhängigen Regeln verarbeitet. Die einfache Rechnung „Zeichen geteilt durch vier“ ist dafür ungeeignet.
Nutze, wenn vorhanden, die Zählfunktion des Anbieters für die vollständige Anfrage und anschließend die zurückgegebenen Nutzungsdaten. Bei OpenAI gibt es dafür einen Endpunkt zur Eingabe-Tokenzählung. Das lokale Beispiel in diesem Eintrag zählt ausschließlich den angegebenen Text; es bildet weder eine vollständige Chat-Anfrage noch eine spätere Antwort ab.
Was dir dieses Wissen im Alltag bringt
Du möchtest zehn lange Dokumente vergleichen? Formuliere zuerst, welche Unterschiede relevant sind. Gib dann die benötigten Informationen mit und lasse Raum für die Antwort. Bei einer Suche über eigene Inhalte kann ein RAG-System passende Ausschnitte auswählen, statt sämtliche Dokumente in jede Anfrage zu kopieren. Dabei muss die Auswahl zur Frage passen.
Kürzen ist kein Selbstzweck. Wenn du wichtige Bedingungen entfernst, wird die Aufgabe unklarer. Ein sinnvolles Token-Budget verbindet deshalb ausreichend Kontext mit einem klaren Auftrag. Prüfe das Ergebnis weiterhin auf Inhalt und Quellen: Eine lange, flüssige Antwort eines LLM kann trotzdem falsch sein.
Codebeispiel aus der Praxis
Vier Tokens selbst nachzählen
Eigenes Beispiel mit Python und dem Paket tiktoken (Installation: python -m pip install tiktoken). Kein API-Schlüssel und kein Modellaufruf erforderlich. Beim ersten Laden kann die öffentliche Tokenizer-Datei heruntergeladen werden. Die IDs und die Rückumwandlung wurden mit cl100k_base lokal geprüft.
import tiktoken

encoding = tiktoken.get_encoding("cl100k_base")
text = "Hello, world!"
ids = encoding.encode(text)

print(ids)                 # [9906, 11, 1917, 0]
print(len(ids))            # 4
print(encoding.decode(ids)) # Hello, world!
Quellen und weiterführende Informationen
- Dokumentation Key concepts: Tokens OpenAI · Geprüft
- Dokumentation How to count tokens with tiktoken OpenAI · Geprüft
- Dokumentation Conversation state: Managing the context window OpenAI · Geprüft
- Dokumentation Counting tokens OpenAI · Geprüft
- Dokumentation Reasoning models OpenAI · Geprüft
- Dokumentation Prompt caching OpenAI · Geprüft
